
Hochverfügbarkeit einrichten
Dieses Dokument beschreibt, wie Sie einen zweiten ZeroPortal-Knoten als Replica an einen bestehenden Server anbinden, was die beiden Knoten im Betrieb tun, wie Sie einen Cluster aktualisieren und was bei einem Ausfall zu tun ist. Es setzt einen installierten Server voraus (siehe Administrationshandbuch, Kapitel 3) und vertieft dessen Kapitel 11.
1. Was ist das?
ZeroPortal kennt zwei Rollen. Der Primary ist der Knoten, dessen Datenbank schreibt: Jede Änderung im Portal, jede Registrierung eines Geräts und jede Lizenzbuchung landet hier. Eine Replica hält eine laufend nachgeführte Kopie dieser Datenbank und liefert daraus Pakete und Richtlinien an die Clients. Jeder frisch installierte Knoten ist zunächst ein eigenständiger Primary; eine Replica entsteht, indem ein zweiter Knoten dem ersten mit einem Einladungs-Token beitritt.
Die Kopie entsteht durch die Binlog-Replikation von MariaDB: Der Primary schreibt jede Änderung in sein Binärlog, die Replica liest dieses Log mit und spielt es in ihre eigene Datenbank ein. Drei Dinge bleiben bewusst je Knoten und werden nicht repliziert: die Knotenkonfiguration (Rolle, Knoten-ID, Wartungsmodus, LDAP-Einstellungen), die Liste der registrierten Knoten und die App-V-Reporting-Tabellen. App-V-Reports nimmt daher nur der Primary entgegen; eine Replica reicht sie dorthin weiter.
Eine Replica ist im Alltag voll bedienbar. Lesen geschieht immer aus der lokalen Kopie. Schreibvorgänge leitet der Knoten unbemerkt an den Primary weiter, es gibt keinen Nur-Lesen-Modus und keinen dauerhaften Hinweis. Nur wenn der Primary nicht erreichbar ist, erscheint auf jeder Seite der gelbe Balken Kein Primary erreichbar.
Der Primary prüft alle registrierten Knoten alle 10 Sekunden über deren Health-Endpunkt. Jede Replica meldet sich alle 5 Minuten per Heartbeat beim Primary; schlägt ein Heartbeat fehl, versucht sie es jede Minute erneut. Beides sehen Sie unter Globale Konfiguration → Hochverfügbarkeit.
2. Wozu ist das gut?
- Ein Server fällt aus oder wird gewartet. Die Clients gleichen mit dem anderen Knoten weiter ab: MSIX-Pakete, App-V-Pakete und Richtlinien kommen aus der lokalen Kopie. Dafür müssen beide Server-URLs in der Gruppenrichtlinie Publishing-Server stehen; ist der erste nicht erreichbar, wechselt der Agent nach 10 Sekunden zum nächsten und meidet den ausgefallenen für 10 Minuten (siehe Administrationshandbuch, Kapitel 11).
- Update ohne Verteilpause. Sie aktualisieren die Knoten nacheinander; während der Primary neu startet, versorgen die Replicas die Clients weiter, und umgekehrt.
-
Schnelle Wiederherstellung. Fällt der Primary dauerhaft aus, befördern Sie eine Replica per Assistent zum neuen Primary. Die Daten sind bereits dort.
-
Lastverteilung für den Abgleich. Schalten Sie in der Gruppenrichtlinie des Agenten Zufällige Serverauswahl ein, würfelt jeder Agent seine Reihenfolge neu und nimmt den ersten erreichbaren Knoten. Die Abgleiche verteilen sich damit gleichmäßig über Primary und Replicas, ohne Load Balancer und ohne gemeinsamen DNS-Namen. Bleibt die Einstellung aus, arbeiten alle Agenten die Liste in derselben Prioritätsreihenfolge ab: Dann trägt der erste Knoten die Last und die übrigen stehen für den Ausfall bereit.
Was eine Replica nicht beschleunigt, sind Schreibvorgänge: Sie landen immer beim Primary, die Replica reicht sie nur weiter. Fehlt der Primary, betrifft das vor allem Sie als Administrator: Änderungen im Portal, neu hinzukommende Geräte und Lizenzbuchungen warten, bis er zurück ist oder eine Replica befördert wurde. Die Benutzer merken davon nichts, ihr Abgleich läuft weiter. Die eine Ausnahme ist das App-V-Reporting: Auch die Berichte der Clients sind Schreibvorgänge und warten mit. Einen automatischen Rollenwechsel gibt es nicht.
Ein einzelner Knoten trägt im Übrigen auch große Flotten; die Hinweise zur Dimensionierung stehen im Administrationshandbuch, Kapitel 2. Die Lastverteilung ist ein willkommener Nebeneffekt der Hochverfügbarkeit, kein Grund allein für einen zweiten Knoten.
3. Die Handgriffe in Kurzform
Alles läuft über Globale Konfiguration → Hochverfügbarkeit auf dem jeweils genannten Knoten. Kein SQL, keine Kommandozeile. Ausführlich stehen die Wege in den folgenden Abschnitten.
Zweiten Knoten aufnehmen
- Auf dem Primary: Neues Token erzeugen, Token kopieren.
- Auf dem neuen Knoten: Als Replica einrichten…, URL des Primary und Token eintragen, Als Replica beitreten.
- Auf dem neuen Knoten: Assistent starten…. Er richtet die Datenbankreplikation auf beiden Seiten ein und holt am Ende die vorhandenen Daten.
Der Primary ist ausgefallen
Nichts überstürzen. Die Clients werden von den Replicas weiter versorgt, Pakete und Richtlinien kommen unverändert an. Nur Änderungen im Portal, neue Geräte, Berichte und Lizenzbuchungen warten. Kommt der Primary bald zurück, holen die Replicas die Lücke von selbst auf.
Eine Replica zum Primary machen
Kommt er nicht zurück, befördern Sie eine Replica. Zwei Klicks, gut eine Minute:
- Auf der Replica: Zurücksetzen / zum Primary befördern → Zum Primary befördern…, bestätigen. Die Daten sind bereits da, es wird nichts kopiert.
- Übrige Replicas neu anbinden: Beim Befördern wird die Knotenliste geleert. Auf dem neuen Primary ein Token erzeugen und jede Replica wie oben beitreten lassen.
Die Agenten müssen Sie nicht anfassen, solange die Adresse des neuen Primary in der Serverliste der Gruppenrichtlinie steht. Sie haben längst auf einen erreichbaren Knoten gewechselt.
Den alten Primary zurückholen
Er kommt als Replica zurück: Token auf dem neuen Primary erzeugen, auf dem alten Knoten Als Replica einrichten…, Assistent laufen lassen. Seine veraltete Datenbank wird dabei überschrieben.
Replikation hängt oder ist abgerissen
Auf der Replica: Erweitert / manuelle Einrichtung, Registerkarte Replica, Full Sync vom Primary…. Das ist der Standardweg für jede Abweichung, auch nach längerem Ausfall.
Knoten aktualisieren
Primary zuerst: MSI installieren, danach das Datenbankupdate auf demselben Knoten ausführen. Erst danach die Replicas, eine nach der anderen, jede vorher in den Wartungsmodus. Grund: Schemaänderungen laufen auf dem Primary und erreichen die Replicas über die Replikation; eine zuerst aktualisierte Replica läuft bis dahin einfach mit dem alten Schema weiter.
4. Einrichtung Schritt für Schritt
Alle Schritte laufen im Portal unter Globale Konfiguration → Hochverfügbarkeit; nötig ist im Bereich Hochverfügbarkeit die Stufe Verwalten oder ein Voll-Administrator-Konto (siehe Benutzer, Rechte, Lizenzen und Protokolle).
4.1 Voraussetzungen
- Zweiter Server installiert (Administrationshandbuch, Kapitel 3) mit eigener MariaDB, möglichst derselben ZeroPortal-Version und demselben Datenbanknamen; der Beitritt prüft das und lehnt sonst ab.
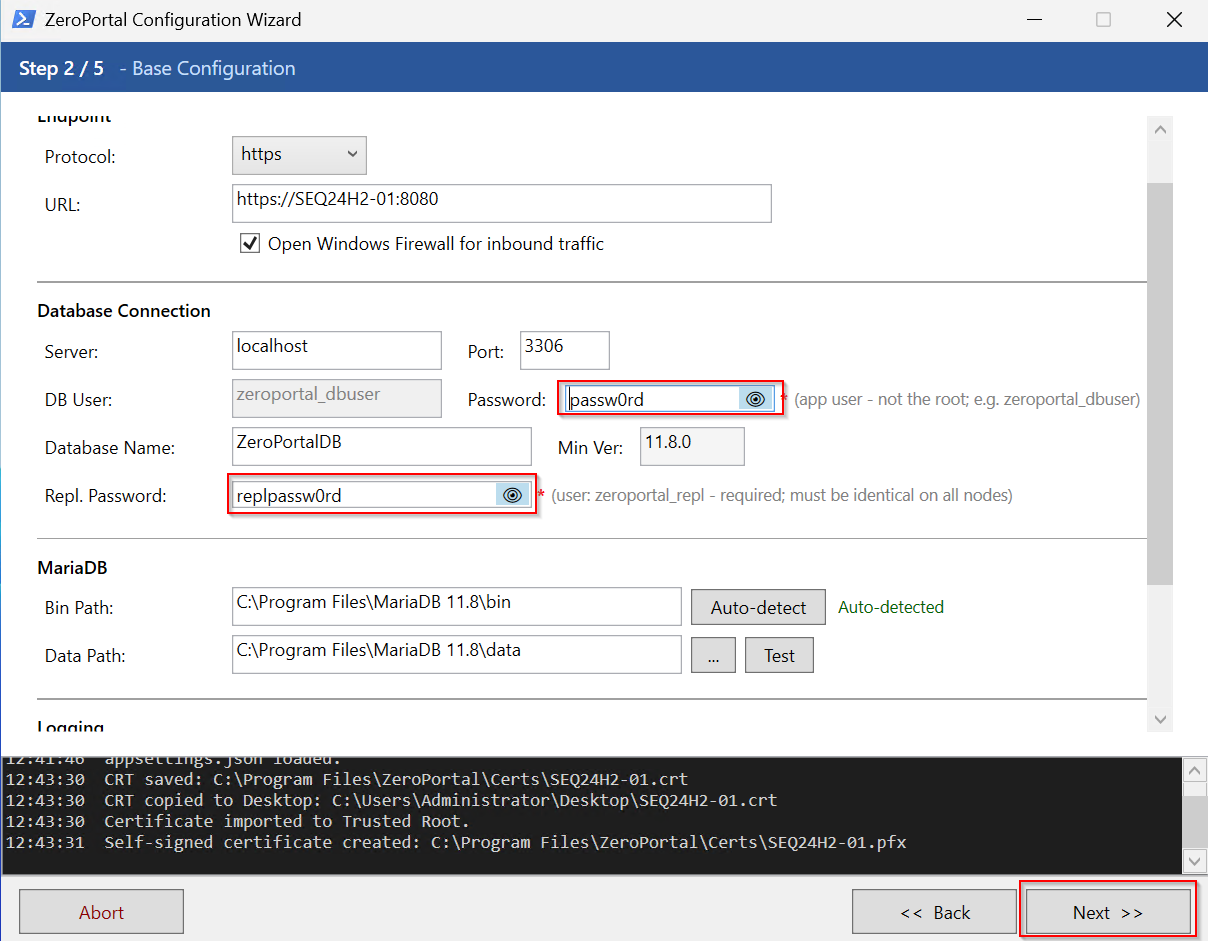
- Konfigurationstool, Schritt 2 - Base Configuration, auf beiden Knoten: Repl.
Password identisch (Kennwort des Datenbankbenutzers
zeroportal_repl); Bin Path per Auto-detect gefüllt, sonst findet der Assistent diemy.ininicht. - Schritt 4 - Database Install / Update auf beiden Knoten mit dem Administratorkonto
der Datenbank: Erst dabei wird
zeroportal_replangelegt bzw. sein Kennwort gesetzt. Nach jeder Änderung des Replikationspassworts auf beiden Knoten wiederholen. - Netzwerk: Portal-Port (HTTPS, z. B. 8080) in beiden Richtungen zwischen den Knoten offen; TCP 3306 von der Replica zum Primary. Die Windows-Firewall-Regel für 3306 legt der Assistent selbst an; Hardware-Firewalls und Sicherheits-Suiten öffnen Sie von Hand.
- Bestandsdaten: Enthält der Primary bereits Pakete, braucht die Replica einmalig einen Full Sync (Abschnitt 4.5). Hat sie noch keine Paketdaten, startet ihn der Assistent selbst.
4.2 Einladungs-Token auf dem Primary erzeugen
Auf dem Primary: Globale Konfiguration → Hochverfügbarkeit → Abschnitt
Einladungs-Token → Neues Token erzeugen → Kopieren. Dazu die Basis-URL des
Primary mit Port notieren, z. B. https://portal1.example.com:8080.
Das Token gilt 24 Stunden und genau für einen Beitritt; ein neues Token macht ein vorhandenes ungültig.
4.3 Den zweiten Knoten beitreten lassen
Auf dem künftigen Replica-Knoten dieselbe Seite öffnen (er zeigt sich noch als Primary):
- Als Replica einrichten… → Basis-URL des Primary eintragen → Testen. Die Antwort nennt Rolle und Datenbankname des Primary; schlägt der Test fehl, stimmen URL, Port, Zertifikat oder Firewall nicht.
- Einladungs-Token einfügen. Die Basis-URL dieses Knotens ist vorbelegt; das ist die Adresse, unter der der Primary diesen Knoten erreicht.
- Als Replica beitreten. Unter Dieser Knoten steht jetzt Rolle Replica; auf dem Primary erscheint der Knoten unter Registrierte Knoten mit Replikation: Nicht gestartet. Die Datenbank koppelt erst der nächste Schritt.
4.4 HA Setup Wizard ausführen
Der Assistent richtet die MariaDB-Replikation auf beiden Knoten ein (my.ini, Firewall,
Neustart des Datenbankdienstes, Kopplung). Sie starten ihn auf der Replica:
- Im Abschnitt Replikations-Assistent auf Assistent starten… klicken. Das Fenster HA Setup Wizard zeigt die geplanten Schritte und vier Felder:
| Feld | Bedeutung |
|---|---|
| DB-Host des Primary | Host oder IP der MariaDB des Primary (vorbelegt aus der Basis-URL) |
| Port | MariaDB-Port des Primary, Standard 3306 |
| Primary-ID | server-id des Primary; Konvention 1. Nur anpassen, wenn der Primary kürzlich befördert wurde und in seiner my.ini noch eine andere ID trägt |
| Server-ID dieses Knotens | eindeutiger Wert ≥ 2, aus der Knoten-ID vorgeschlagen; muss sich von der Primary-ID unterscheiden |
- Assistent starten bestätigen. Der Assistent zeigt jeden seiner Schritte mit Ergebnis.
Geht etwas schief, spielt er die
my.iniauf beiden Knoten zurück und bricht ab; scheitert nur ein Firewall-Schritt, läuft er weiter. - Fenster schließen. Hatte die Replica noch keine Paketdaten, öffnet sich stattdessen sofort der Full Sync (Abschnitt 4.5).
Während des Assistenten ist der Primary für einige Sekunden ohne Datenbank (Neustart von MariaDB). Planen Sie die Einrichtung in eine ruhige Zeit.
4.5 Full Sync: vorhandene Daten auf die Replica kopieren
Die Replikation überträgt nur Änderungen ab der Binlog-Position, an der sie gestartet wurde. Der Full Sync holt einen vollständigen Dump vom Primary, spielt ihn lokal ein und startet die Replikation ab genau der Position, die zum Dump gehört.
- Automatisch am Ende des HA Setup Wizards, wenn die Replica noch keine Paketdaten hat; die Seite kündigt das vorher an.
- Von Hand: Erweitert / manuelle Einrichtung → Registerkarte Replica → Full Sync vom Primary…. Host und Port des Primary nimmt der Dialog aus derselben Registerkarte.
Der gesamte lokale Datenbankinhalt wird ersetzt, das Portal auf diesem Knoten ist kurz nicht erreichbar, und der Vorgang lässt sich nicht rückgängig machen. Knotenkonfiguration, Knotenliste und App-V-Reporting-Tabellen sind vom Dump ausgenommen; die Replica behält Rolle und Knoten-ID.
Ein Full Sync ist später erneut nötig, wenn eine Replica länger als sieben Tage vom Primary getrennt war, aus einem Snapshot zurückgesetzt wurde oder der SQL-Thread wegen abweichender Daten steht (Abschnitt 6.4).
4.6 Ergebnis prüfen
- Registrierte Knoten auf beiden Knoten: Punkt grün, Spalte Replikation bei der Replica
OK: <Datum>oder0 s: <Datum>. - Replica, Registerkarte Replica → Status aktualisieren: IO läuft: Yes, SQL läuft: Yes, Rückstand (s): 0, Letzter Fehler leer.
- Beide Server-URLs in der Gruppenrichtlinie Publishing-Server eintragen (siehe Client-Agent: Betrieb und Rollout).
5. Regeln: wann wirkt was
5.1 Was wo geschrieben wird, und wann
| Was | Regel |
|---|---|
| Pakete, Richtlinien, Zuweisungen lesen (Agent-Abgleich) | lokal auf jedem Knoten |
| Änderungen im Portal, Registrierung, Lizenzbuchung, Audit, App-V-Reports | Replica leitet an den Primary weiter; scheitert nach 5 s, danach 30 s Schnellabbruch, dann neuer Versuch |
| Rolle, Knoten-ID, Wartungsmodus, LDAP-Einstellungen | je Knoten, nicht repliziert |
| Liste der registrierten Knoten | Primary führend; die Seite einer Replica fragt den Primary live |
| Primary prüft jeden registrierten Knoten | alle 10 s; die Anzeige Registrierte Knoten ebenso |
| Heartbeat der Replica | alle 5 min, nach einem Fehlschlag jede Minute; überfällig nach Intervall + 1 min |
| Einladungs-Token | 24 h, einmalig |
| IO-Thread „Connecting" nach Primary-Neustart | bis 10 min toleriert, danach Alarm Database replication stopped |
| Binärlog auf dem Primary | 7 Tage; eine länger fehlende Replica braucht einen Full Sync |
Die Umschaltung Schreib-Routing unter Dieser Knoten einer Replica lassen Sie auf Aktiv. Deaktiviert verwirft alle weitergeleiteten Schreibzugriffe stillschweigend; das ist ausschließlich ein Diagnoseschalter.
5.2 Statusanzeigen unter Registrierte Knoten
Der Punkt fasst den Zustand zusammen (Wartung vor Erreichbarkeit vor Replikation), der Tooltip nennt die Ursache: Blau Wartungsmodus; Grün erreichbar, Heartbeat frisch, Rückstand unter 60 s; Gelb vorübergehend (Knoten antwortet nicht, Heartbeat aber frisch; Heartbeat überfällig; Rückstand 60–299 s); Rot Eingriff nötig (nicht erreichbar und Heartbeat überfällig; SQL-Thread gestoppt; Rückstand ab 300 s; auf einer Replica: Primary nicht erreichbar); Grau noch nicht geprüft.
Spalte Replikation: OK: <Datum> oder <n> s: <Datum> = beide Threads laufen, n Sekunden
Rückstand; IO gestoppt → Abschnitte 6.3 und 6.4; SQL gestoppt → Wartung beenden bzw.
Abschnitt 6.4; Nicht gestartet → HA Setup Wizard (auf der Replica ist der Text ein Link).
Nur ein gestoppter SQL-Thread färbt den Punkt rot. Nach einem Neustart des Primary meldet
MariaDB den IO-Thread als „Connecting" und verbindet sich von selbst wieder; erst ein echter
Fehler (ungültige Binlog-Position 1236, falsches Replikationspasswort, TLS) stoppt ihn.
5.3 Wartungsmodus
Der Wartungsmodus hält auf einer Replica den SQL-Thread an: Änderungen des Primary werden weiter empfangen, aber erst nach dem Beenden eingespielt. Der Punkt wird blau, der Knoten bleibt für Clients erreichbar. Gedacht für Arbeiten an der Replica, bei denen die Datenbank nicht mitlaufen soll (Update der Programmdateien, Wartung von MariaDB).
- Auf dem Primary schaltet die Spalte Wartung je Knoten mit Ein / Aus; Alle in Wartung und Alle fortsetzen wirken auf alle Replicas.
- Aus startet beide Replikations-Threads. Alle fortsetzen ist damit auch der bequeme Weg, eine gestoppte Replikation neu anzustoßen.
- Ein Wartungsmodus des Primary hat keine Wirkung auf die Replikation.
5.4 Wenn der Primary ausfällt
| Replica ohne Primary | |
|---|---|
| Portal auf der Replica | antwortet normal; Aufgaben, die den Primary brauchen, werden im Hintergrund wiederholt |
| Verteilung (MSIX, App-V, Richtlinien) | läuft weiter, Lesen ist lokal |
| Verwaltung, Registrierung, Berichte, Lizenzbuchung | warten; jeder Schreibvorgang scheitert nach 5 s, dann 30 s sofort, dann neuer Versuch |
| Sichtbar | Balken Kein Primary erreichbar auf jeder Seite (mit Zeitpunkt); /api/health/status liefert primaryReachable: false; E-Mail Primary not reachable (sent by the replica) |
| Erkennung | beim nächsten Heartbeat oder sofort beim ersten weitergeleiteten Schreibzugriff; danach Heartbeat jede Minute |
| Rückkehr des Primary | von selbst; E-Mail Primary reachable again und Audit-Eintrag Cluster.PrimaryRecovered mit dem Ausfallfenster |
| Primary kommt nicht zurück | Replica befördern, Abschnitt 6.2 |
Der Primary kann seinen eigenen Ausfall nicht melden; diese eine Meldung schickt die Replica, alle anderen Cluster-Meldungen kommen vom Primary.
Grenzen: genau ein Primary, beliebig viele Replicas mit je eigener Server-ID; kein automatischer Failover, die Beförderung ist ein bewusster Schritt des Administrators; nach mehr als 7 Tagen Trennung oder einem Snapshot-Rollback der Replica ist ein Full Sync nötig.
5.5 Knoten entfernen
- Auf dem Primary: Papierkorb-Symbol in der letzten Spalte. Löscht nur den Eintrag in der Knotenliste; die Replica bemerkt es beim nächsten Heartbeat (spätestens nach 5 Minuten) und setzt sich selbst auf einen eigenständigen Primary zurück.
- Auf der Replica: Entfernen neben der Primary-URL unter Dieser Knoten. Der Knoten wird sofort ein eigenständiger Primary und meldet sich beim bisherigen Primary ab.
In beiden Fällen läuft die MariaDB-Replikation weiter. Soll der Knoten nicht wieder
beitreten, danach auf ihm Erweitert / manuelle Einrichtung → Registerkarte Replica →
Replica zurücksetzen (RESET REPLICA ALL) ausführen oder den Beförderungs-Assistenten
laufen lassen (Abschnitt 6.2), der zusätzlich die server-id auf 1 setzt.
6. Betrieb und Fehlersuche
6.1 Update im Cluster
Die Schemaänderungen laufen auf dem Primary und erreichen die Replicas über die Replikation;
ZDBInstallUpdate läuft trotzdem auf jedem Knoten, weil es dort die knotenlokalen
Tabellen abgleicht.
- Primary: MSI installieren, danach das Datenbankupdate ausführen:
"C:\Program Files\ZeroPortal\ZDBInstallUpdate.exe" "C:\Program Files\ZeroPortal\appsettings.json" --admin-user root --admin-password <Passwort>DienstZeroPortalprüfen bzw. starten. Die Replicas laufen mit dem alten Stand weiter. - Replicas, eine nach der anderen: MSI installieren,
ZDBInstallUpdatemit derselben Kommandozeile ausführen, Dienst prüfen. Erwartete Meldung dort:Schema migration skipped on this replica (deferred to the Primary)undLOCAL_TABLES: …. - Kontrolle: HA-Seite des Primary, alle Knoten grün, Spalte Replikation
OK; Version in der Fußzeile jedes Knotens.
Dasselbe erledigt das Konfigurationstool in Schritt 4 - Database Install / Update. Eine
versehentlich zuerst aktualisierte Replica meldet REPLICA_SCHEMA_DEFERRED=1 (Exit-Code 19)
und läuft auf dem alten Schema weiter, bis der Primary nachzieht; die Replikation bleibt
intakt. Für ein Update von MariaDB gilt die umgekehrte Reihenfolge (zuerst die Replicas,
zuletzt der Primary; Administrationshandbuch, Kapitel 12).
6.2 Primary verloren: Replica befördern
Der Klickweg steht in Abschnitt 3. Drei Dinge, die dort nicht hineinpassen:
- Die richtige Replica wählen. Bei mehreren Replicas die mit dem kleinsten Rückstand: Erweitert / manuelle Einrichtung → Replica → Status aktualisieren, Feld Rückstand (s).
- Was der Assistent tut. Replikation stoppen und zurücksetzen, Rolle auf Primary setzen,
Knotenliste leeren,
server-id = 1in diemy.inischreiben, MariaDB neu starten, prüfen. Anschließend verschickt der Knoten die Meldung Failover: this node became Primary. - Der alte Primary darf nicht einfach wieder anlaufen. Er hält sich weiter für den
Primary und nähme Änderungen an, die den neuen nie erreichen. Vor dem Einschalten den
Dienst
ZeroPortaldeaktivieren oder den Server vom Netz nehmen; danach als Replica anbinden und mit einem Full Sync überschreiben.
Ein DNS-Alias oder Load Balancer, der auf den alten Primary zeigt, muss umgestellt werden. Die Agenten brauchen keine Änderung, solange beide Adressen in der Richtlinie Publishing-Server stehen.
6.3 Nach einem harten Ausfall des Primary
Wurde der Primary ohne sauberes Herunterfahren abgeschaltet, zeigen die Replicas danach
manchmal IO gestoppt mit Got fatal error 1236 … start replication from position > file
size: Die Replica merkt sich eine Binlog-Position, die es nach dem Neustart nicht mehr gibt.
Alle fortsetzen hilft hier nicht; die Abhilfe ist Full Sync vom Primary… auf der
betroffenen Replica. Vorbeugen: den Primary sauber herunterfahren oder wenigstens den
MariaDB-Dienst vorher stoppen.
6.4 Replikation neu starten oder zurücksetzen
| Situation | Weg |
|---|---|
| SQL gestoppt nach Wartung | Wartungsmodus beenden (Aus bzw. Alle fortsetzen) |
| SQL gestoppt oder Gestoppt ohne erkennbaren Grund | auf dem Primary Alle fortsetzen oder auf der Replica START REPLICA; |
Letzter Fehler Duplicate entry, Can't find record, doesn't exist |
die Replica hat abweichende Daten (die Registerkarte Replica zeigt Möglicherweise ist ein Full Sync nötig): Full Sync vom Primary… |
IO gestoppt mit Access denied |
Replikationspasswort stimmt auf den Knoten nicht überein: in Schritt 2 des Konfigurationstools auf beiden Knoten gleich setzen, Schritt 4 auf dem Primary ausführen, HA Setup Wizard erneut starten |
| IO gestoppt mit Fehler 1236 | Abschnitt 6.3 |
| Replikation komplett neu aufsetzen | Registerkarte Replica → Replica zurücksetzen (RESET REPLICA ALL), dann HA Setup Wizard |
6.5 Sicherungskopie der my.ini
Assistent und Beförderung schreiben in die my.ini von MariaDB (im Ordner data neben
bin, alternativ my.cnf) und legen vorher daneben my.ini.zeroportal.bak an; jeder
weitere Lauf überschreibt diese Kopie. Den Stand vor der HA-Einrichtung sichern Sie
vorher selbst. Zurückspielen: Erweitert / manuelle Einrichtung → Registerkarte my.cnf →
Sicherung zurückspielen, danach Auf diesem Knoten neu starten (MariaDB-Dienst).
6.6 Protokolle und Meldungen
Portal-Log: C:\ProgramData\NickIT\ZPServer\Logs\ZeroPortalLogs.log (ältere Installationen:
C:\Windows\Temp\ZeroPortalLogs); Stufe Warning zeigt nur Übergänge und Fehler, Details
erst mit Information (Konfigurationstool, Schritt 2, Log level; danach zurückstellen).
Cluster-Zeilen beginnen mit NodeReachability:, PrimaryLink:, Heartbeat:, HA:,
SetupWizard: und PromoteWizard:. E-Mail-Meldungen (Anhang 7.4) konfigurieren Sie unter
Globale Konfiguration → Konfiguration → E-Mail-Benachrichtigungen; jede steht zusätzlich
im Audit-Protokoll als Alert.Raised. Für Monitoring ohne Anmeldung: Anhang 7.5.
6.7 Häufige Fehler
| Symptom | Ursache | Abhilfe |
|---|---|---|
| Testen beim Beitritt schlägt fehl; Punkt gelb mit SSL certificate validation failed | URL, Port, Portal-Port in der Firewall oder nicht akzeptiertes Zertifikat | URL mit Port prüfen; SslSettings:IgnoreSslErrors in der appsettings.json auf true (Standard) oder vertrauenswürdiges Zertifikat |
| Beitritt: Database name mismatch | Datenbankname auf beiden Knoten verschieden | Datenbank auf der Replica mit demselben Namen anlegen (Konfigurationstool, Schritt 2 und 4) |
| Beitritt: No valid invitation token / Invalid invitation token | Token abgelaufen (24 h), bereits benutzt oder falsch kopiert | auf dem Primary Neues Token erzeugen |
| Beitritt: Beitritt zu sich selbst nicht möglich | die Primary-URL zeigt auf diesen Knoten | URL des anderen Servers eintragen |
Wizard: my.cnf not found; nach Beförderung bleibt server_id alt |
Bin Path fehlt in der appsettings.json oder MariaDB wurde verschoben |
Konfigurationstool, Schritt 2, Auto-detect, speichern, Dienst neu starten; notfalls server-id = 1 von Hand setzen und MariaDB neu starten |
Wizard: Timeout bei Wait for Primary MariaDB; IO läuft: No mit error connecting |
Port 3306 zum Primary blockiert oder bind-address = 127.0.0.1 |
Test-NetConnection <primary> -Port 3306; Registerkarte my.cnf auf dem Primary prüfen; DB-Host im Wizard prüfen |
| Wizard: Server-ID conflict | beide Knoten haben dieselbe server-id |
im Wizard eine andere Server-ID dieses Knotens wählen |
| Wizard: Could not fetch binlog position | log_bin auf dem Primary aus, meist weil MariaDB nach dem Schreiben der my.ini nicht neu gestartet wurde |
Registerkarte my.cnf → Auf dem Primary neu starten |
IO läuft: No mit Access denied; SQL gestoppt mit Duplicate entry; Fehler 1236 |
siehe Abschnitt 6.4 | Abschnitt 6.4 |
| Punkt gelb, Tooltip Heartbeat overdue | Replica hat sich länger als Intervall + 1 min nicht gemeldet | Dienst und Netz der Replica prüfen; nach einem Primary-Neustart verschwindet es binnen einer Minute |
Dienst startet auf einer Replica nach dem Update nicht, Log Unknown column |
ZDBInstallUpdate wurde auf der Replica nicht ausgeführt |
Abschnitt 6.1 |
| Manuell: Binlog-Position vom Primary holen meldet Access denied | der Button nutzt die lokalen App-Zugangsdaten; auf dem Primary ist das Passwort ein anderes oder dem Benutzer fehlt BINLOG MONITOR |
HA Setup Wizard verwenden (er nutzt zeroportal_repl), sonst Schritt 4 des Konfigurationstools auf dem Primary ausführen. Der Fehlertext nennt zeroportal_app; gemeint ist der App-Benutzer aus der Verbindungszeichenfolge, standardmäßig zeroportal_dbuser |
| Balken Kein Primary erreichbar auf der Replica | Primary aus, Netz oder Portal-Port | Abschnitt 5.4; bleibt der Primary weg: Abschnitt 6.2 |
7. Anhang: Technische Referenz
7.1 Einträge in der appsettings.json
| Schlüssel | Bedeutung |
|---|---|
ReplicationSettings:ReplPassword |
Kennwort des Replikationsbenutzers zeroportal_repl; auf allen Knoten gleich (Konfigurationstool, Schritt 2, Repl. Password) |
MySqlSettings:BinPath |
Ordner mit mysql.exe/mysqldump.exe; die my.ini wird relativ dazu gesucht (Schritt 2, Bin Path) |
MySqlSettings:DataPath |
Datenverzeichnis von MariaDB (Schritt 2, Data Path) |
SslSettings:IgnoreSslErrors |
true (Standard): Knoten akzeptieren untereinander selbstsignierte Zertifikate |
Logging:Console:LogLevel:System.Net.Http.HttpClient.HaClient |
Warning: keine Zeile je Heartbeat im Log; bei älteren Installationen nachtragen, wenn das Log durch Start processing HTTP request wächst |
Suchreihenfolge der my.ini, ausgehend vom übergeordneten Ordner von Bin Path:
data\my.cnf, data\my.ini, my.cnf, my.ini.
7.2 Firewall und Dienst
Regelname MariaDB HA Replication (ZeroPortal) :3306, angelegt nur, wenn sie fehlt:
New-NetFirewallRule -DisplayName "MariaDB HA Replication (ZeroPortal) :3306" -Direction Inbound -Protocol TCP -LocalPort 3306 -Action Allow -Profile Domain,Private
Dienstneustart: Dienstnamen MariaDB, MySQL, mariadbd in dieser Reihenfolge,
Restart-Service -Force.
7.3 ZDBInstallUpdate
"C:\Program Files\ZeroPortal\ZDBInstallUpdate.exe" "<Pfad>\appsettings.json" --admin-user <user> --admin-password <pw> [--create-app-user] [--repl-password <pw>] [--check] [--force-migrate]
| Ausgabe / Exit-Code | Bedeutung |
|---|---|
NODE_ROLE=Primary / Proxy |
erkannte Rolle des Knotens |
REPLICA_SCHEMA_DEFERRED=1, Exit 19 |
Replica: ausstehende Schemaänderungen kommen vom Primary; nur knotenlokale Tabellen wurden abgeglichen |
LOCAL_TABLES: … |
Abgleich der knotenlokalen Tabellen |
| Exit 0 | erfolgreich bzw. mit --check auf dem Stand |
Exit 13 (nur --check) |
Schemaänderungen oder Abgleich stehen aus |
| Exit 18 | Schema aktualisiert, aber eine knotenlokale Tabelle konnte nicht abgeglichen werden |
--force-migrate |
Schemaänderungen trotz Replica-Rolle lokal anwenden (nur wenn der Primary verloren ist); danach ist ein Full Sync nötig |
7.4 Meldungen und Audit
| Meldung | Absender | Auslöser |
|---|---|---|
| Cluster node unreachable / Cluster node reachable again | Primary | Health-Endpunkt eines Knotens antwortet nicht mehr bzw. wieder |
| Database replication stopped | Primary | IO- oder SQL-Thread einer Replica gestoppt, oder IO-Thread länger als 10 min in „Connecting" |
| Primary not reachable (sent by the replica) / Primary reachable again (sent by the replica) | Replica | Heartbeat oder weitergeleiteter Schreibvorgang scheitert bzw. gelingt wieder |
| Failover: this node became Primary | beförderter Knoten | Beförderung zum Primary |
Audit-Einträge: Alert.Raised für jede versandte Meldung, Cluster.PrimaryRecovered mit
dem Ausfallfenster.
7.5 PowerShell-Modul und API
| Cmdlet | Zweck |
|---|---|
Get-ZeroPortalHealth [-TargetUrl <url>] |
Rolle, Knoten-ID, primaryReachable eines Knotens |
Get-ZeroPortalReplicationStatus [-TargetUrl <url>] |
IO/SQL-Zustand, Rückstand, letzter Fehler einer Replica |
Get-ZeroPortalClusterNode [-Name <muster>] |
Knotenliste des verbundenen Knotens |
Remove-ZeroPortalClusterNode -NodeId <guid> oder -Name <name> |
Eintrag aus der Knotenliste entfernen (wie das Papierkorb-Symbol) |
Aliasse: Get-ZPClusterNode, Remove-ZPClusterNode. Die Basis-URL setzen Sie vorher mit
Set-AppvZeroPortalCmdLetConfiguration.
| Route | Anmeldung | Inhalt |
|---|---|---|
GET /api/health/status |
keine | Rolle, Knoten-ID, primaryReachable (nur Replica) |
GET /api/health/replication |
keine | ioRunning, ioConnecting, sqlRunning, lagSeconds, lastError, lastIoError |